---
title: "Presenze turistiche in Italia, 1956–2025: dalla crescita di massa a un nuovo record"
description: "Un'analisi riproducibile degli arrivi e delle presenze nelle strutture ricettive italiane, dalla lunga serie storica alla ripresa post-pandemica."
author: "Federico Viscioletti"
image: "images/italian-tourism-occupancy-analysis.png"
date: "2026-08-10"
lang: it
categories: [data-science, python, tourism, data-visualization]
translations:
en: /posts/2026/08/10/italian-tourism-occupancy-analysis/
pillar: data-science-insights
cluster: data-cleaning
pillar-stage: case-study
jupyter: python3
format:
html:
toc: true
code-fold: false
code-tools: true
code-overflow: wrap
embed-resources: false
fig-responsive: true
execute:
warning: false
message: false
echo: true
cache: false
fig-width: 7
fig-height: 4.2
fig-align: center
out-width: 100%
---
<style>
img.cover {
width: 100%;
aspect-ratio: 16 / 9;
object-fit: cover;
object-position: center 45%;
}
.image-credit {
margin-top: -0.5rem;
color: #7a7974;
font-size: 0.8rem;
text-align: right;
}
</style>
<script src="https://cdn.plot.ly/plotly-3.6.0.min.js"></script>
<img src="images/italian-tourism-occupancy-analysis.png" title="Vista aerea di ombrelloni da spiaggia blu e bianchi" class="cover" />
<p class="image-credit">Foto originale di <a href="https://unsplash.com/it/@rgaleriacom?utm_source=unsplash&utm_medium=referral&utm_content=creditCopyText">Ricardo Gomez Angel</a> su <a href="https://unsplash.com/it/foto/fotografia-aerea-di-ombrelloni-da-giardino-blu-e-bianchi-hlmuzhcpCkY?utm_source=unsplash&utm_medium=referral&utm_content=creditCopyText">Unsplash</a>.</p>
# Introduzione
È estate, fa caldo e sto pensando alle vacanze. Più precisamente, penso al mare: spiagge affollate, alberghi pieni e la solita domanda su dove stiano andando tutti.
Questo mi ha spinto a guardare i dati sul turismo. Non solo per scoprire quante persone visitano l'Italia, ma per capire come il turismo sia cambiato nel tempo, quali luoghi ricevano più visitatori, da dove arrivino e quanto l'intero sistema dipenda ancora da pochi mesi estivi.
I dati provengono da tre file ISTAT. Il primo contiene la serie nazionale dal 1956 al 2025; il secondo descrive il turismo recente per provincia e Paese di residenza degli ospiti; il terzo dettaglia i dati per comune italiano e per singolo mese. Non sono stati progettati esattamente per raccontare una storia, quindi la prima parte del lavoro consiste nel rendere coerenti livelli e definizioni diverse.
La domanda principale a cui volevo rispondere era:
> **Come è cambiato il turismo italiano nel tempo e come appare la ripresa più recente quando separiamo arrivi, presenze, destinazioni, residenza degli ospiti e stagionalità?**
## Risposte rapide sul turismo italiano
**Il turismo italiano è cresciuto nel lungo periodo?** Sì. Le presenze nelle strutture ricettive sono aumentate da 52,6 milioni nel 1956 a 436,7 milioni nel 2019. Il dato provvisorio del 2025 è ancora più alto: 535,5 milioni di presenze.
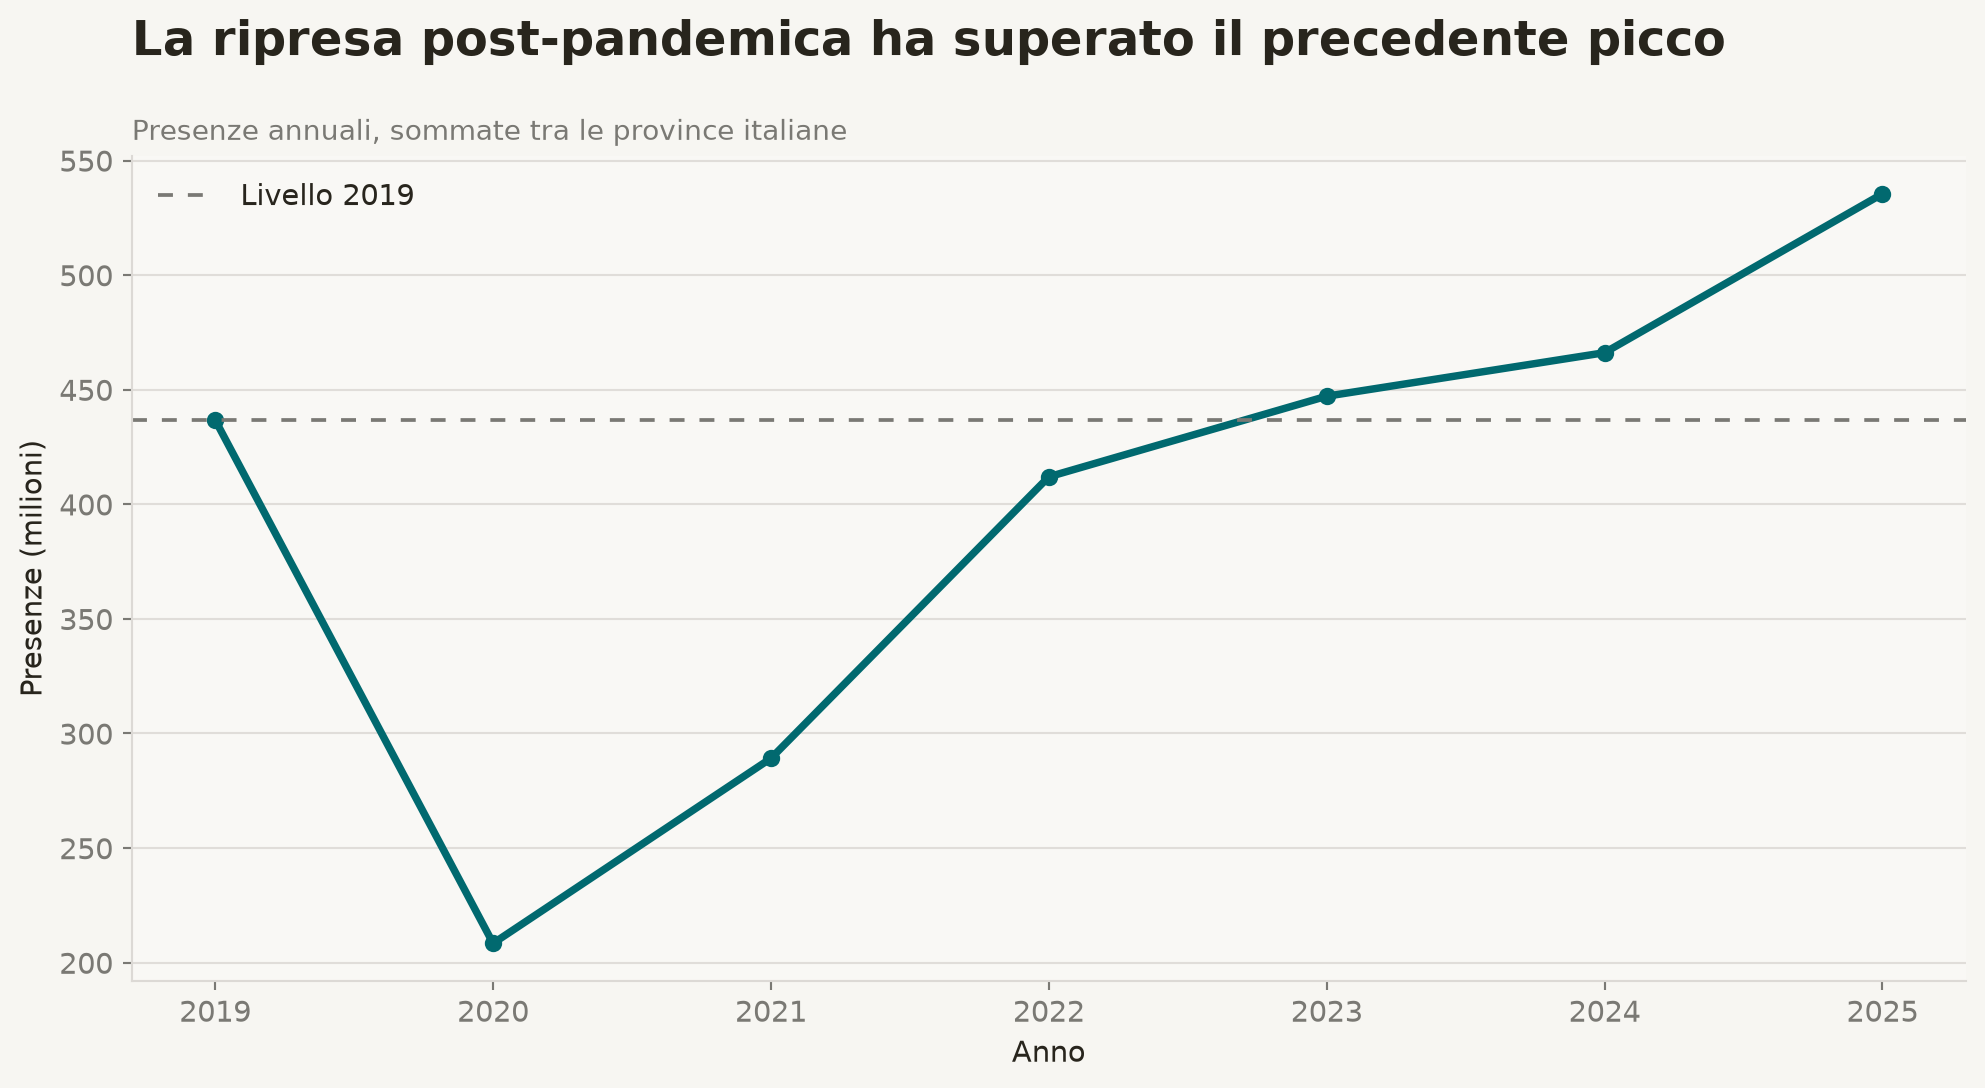
**Che cosa ha fatto la pandemia?** Le presenze sono scese a 208,4 milioni nel 2020 — circa il 52% in meno rispetto al 2019 — per poi recuperare a 466,2 milioni nel 2024 e 535,5 milioni nel 2025.
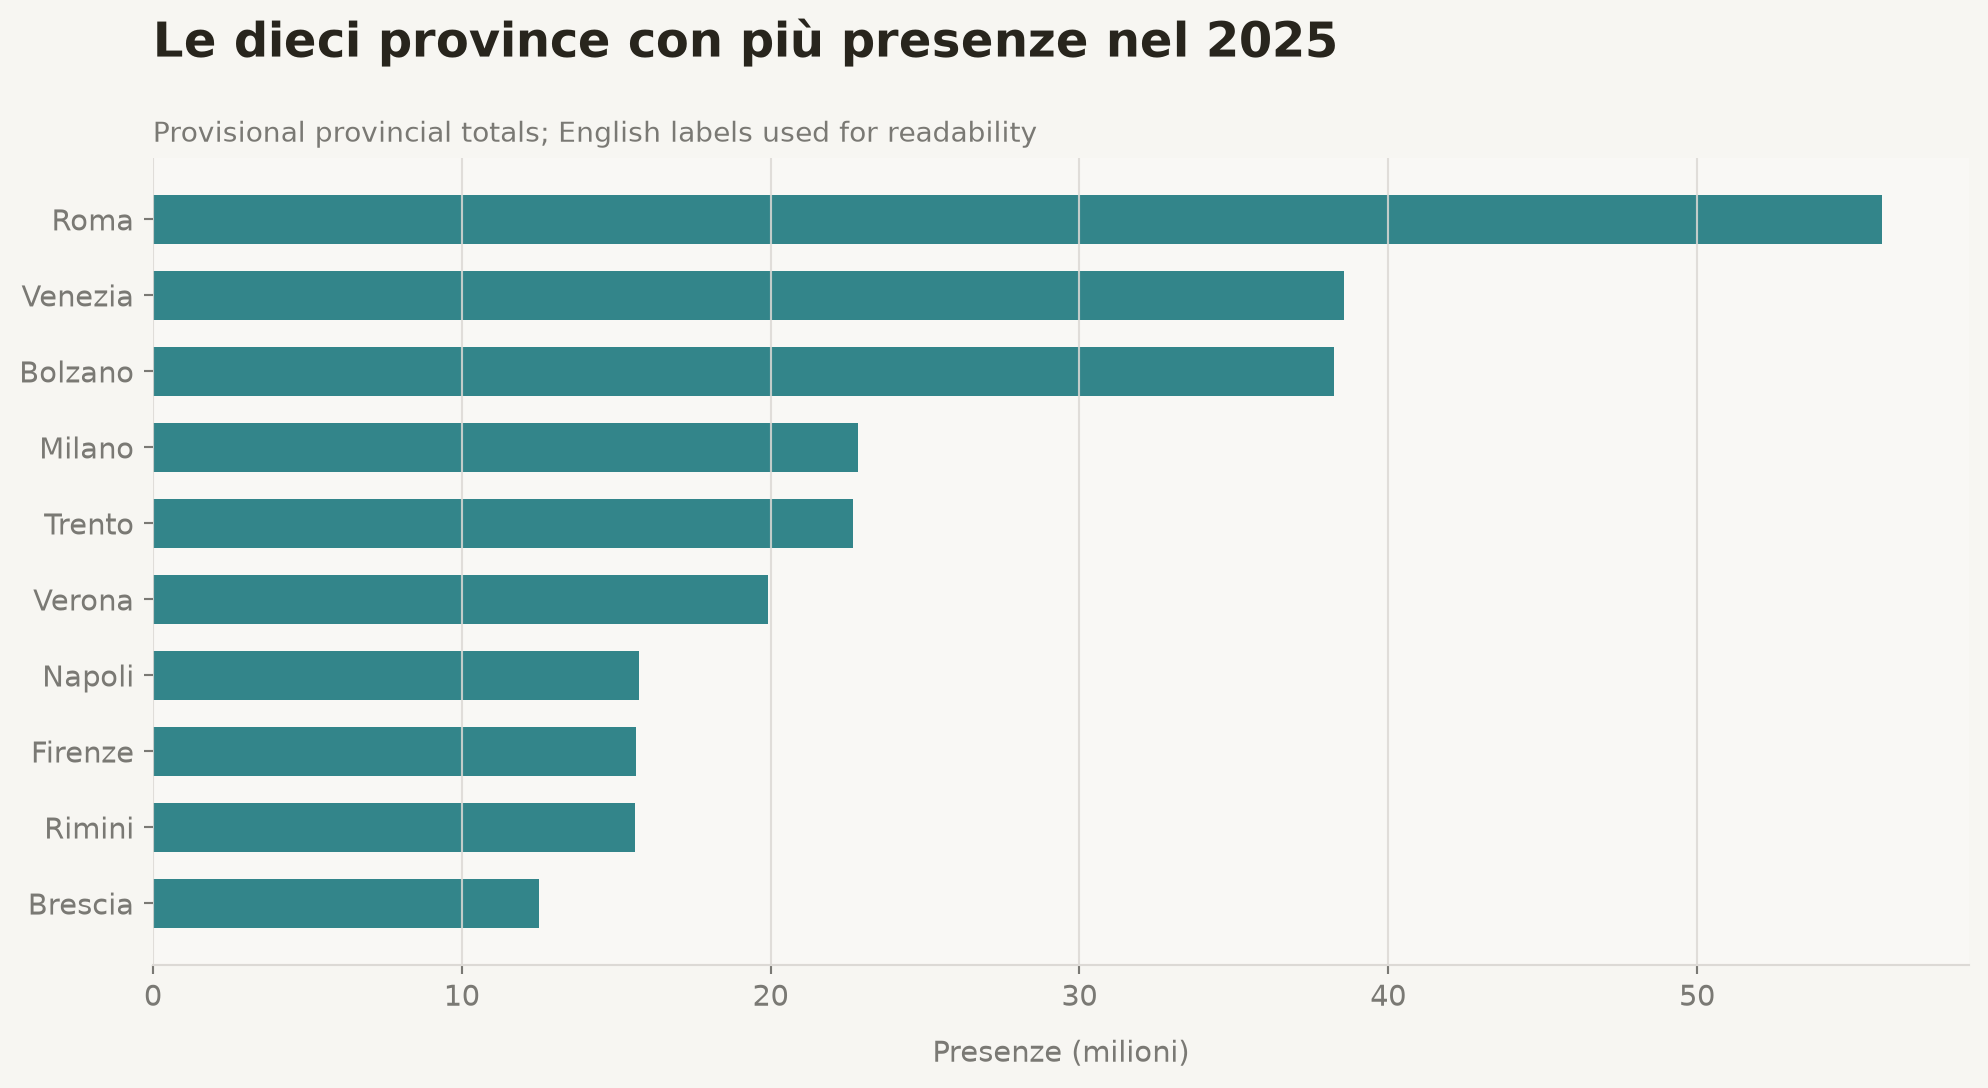
**Dove si concentra il turismo?** Nel 2025 Roma, Venezia, Bolzano, Milano e Trento erano le province con più presenze. La tabella comunale racconta una storia simile, con Roma, Milano, Venezia e Firenze ai primi posti.
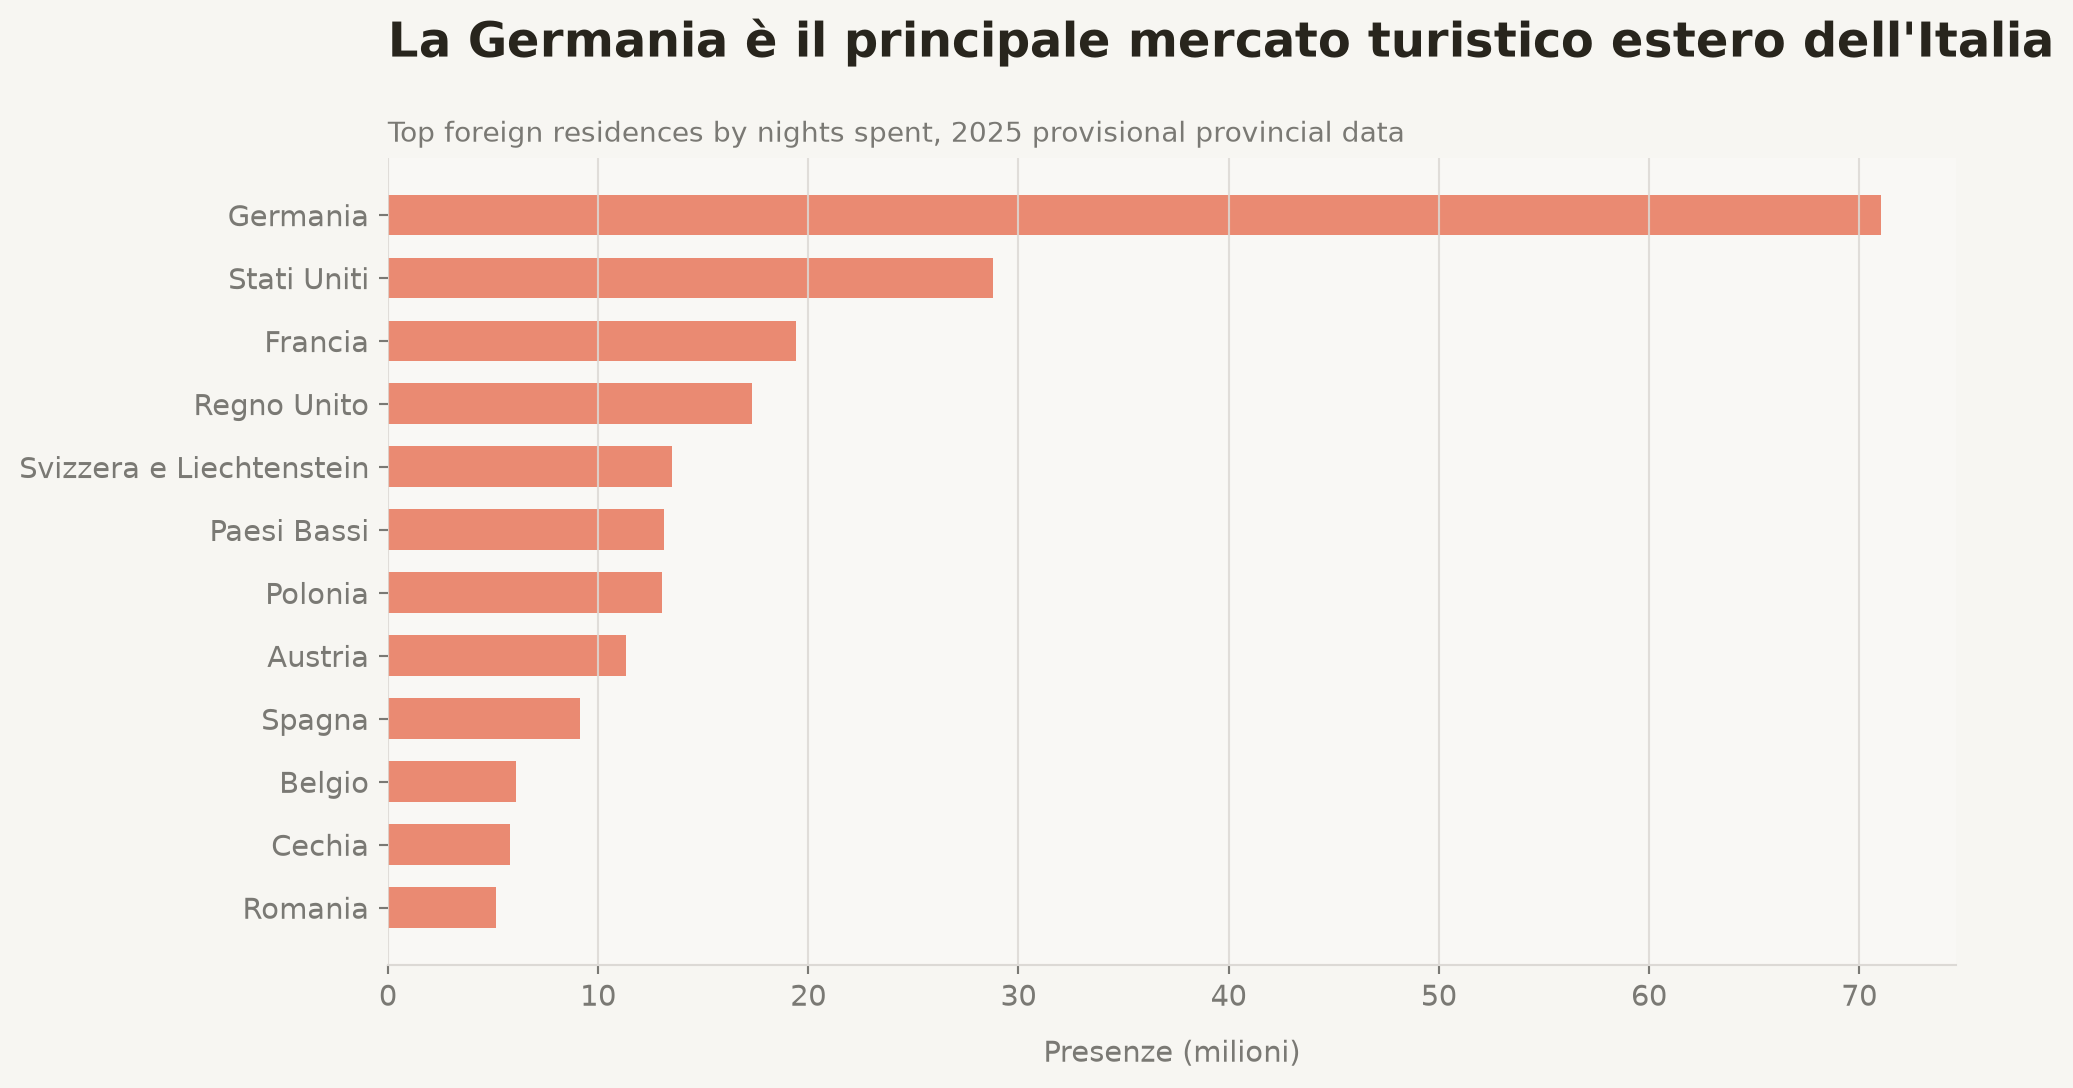
**Chi sono i visitatori internazionali?** Nella tabella provinciale per residenza, la Germania è il principale mercato estero nel 2025, seguita da Stati Uniti, Francia e Regno Unito.
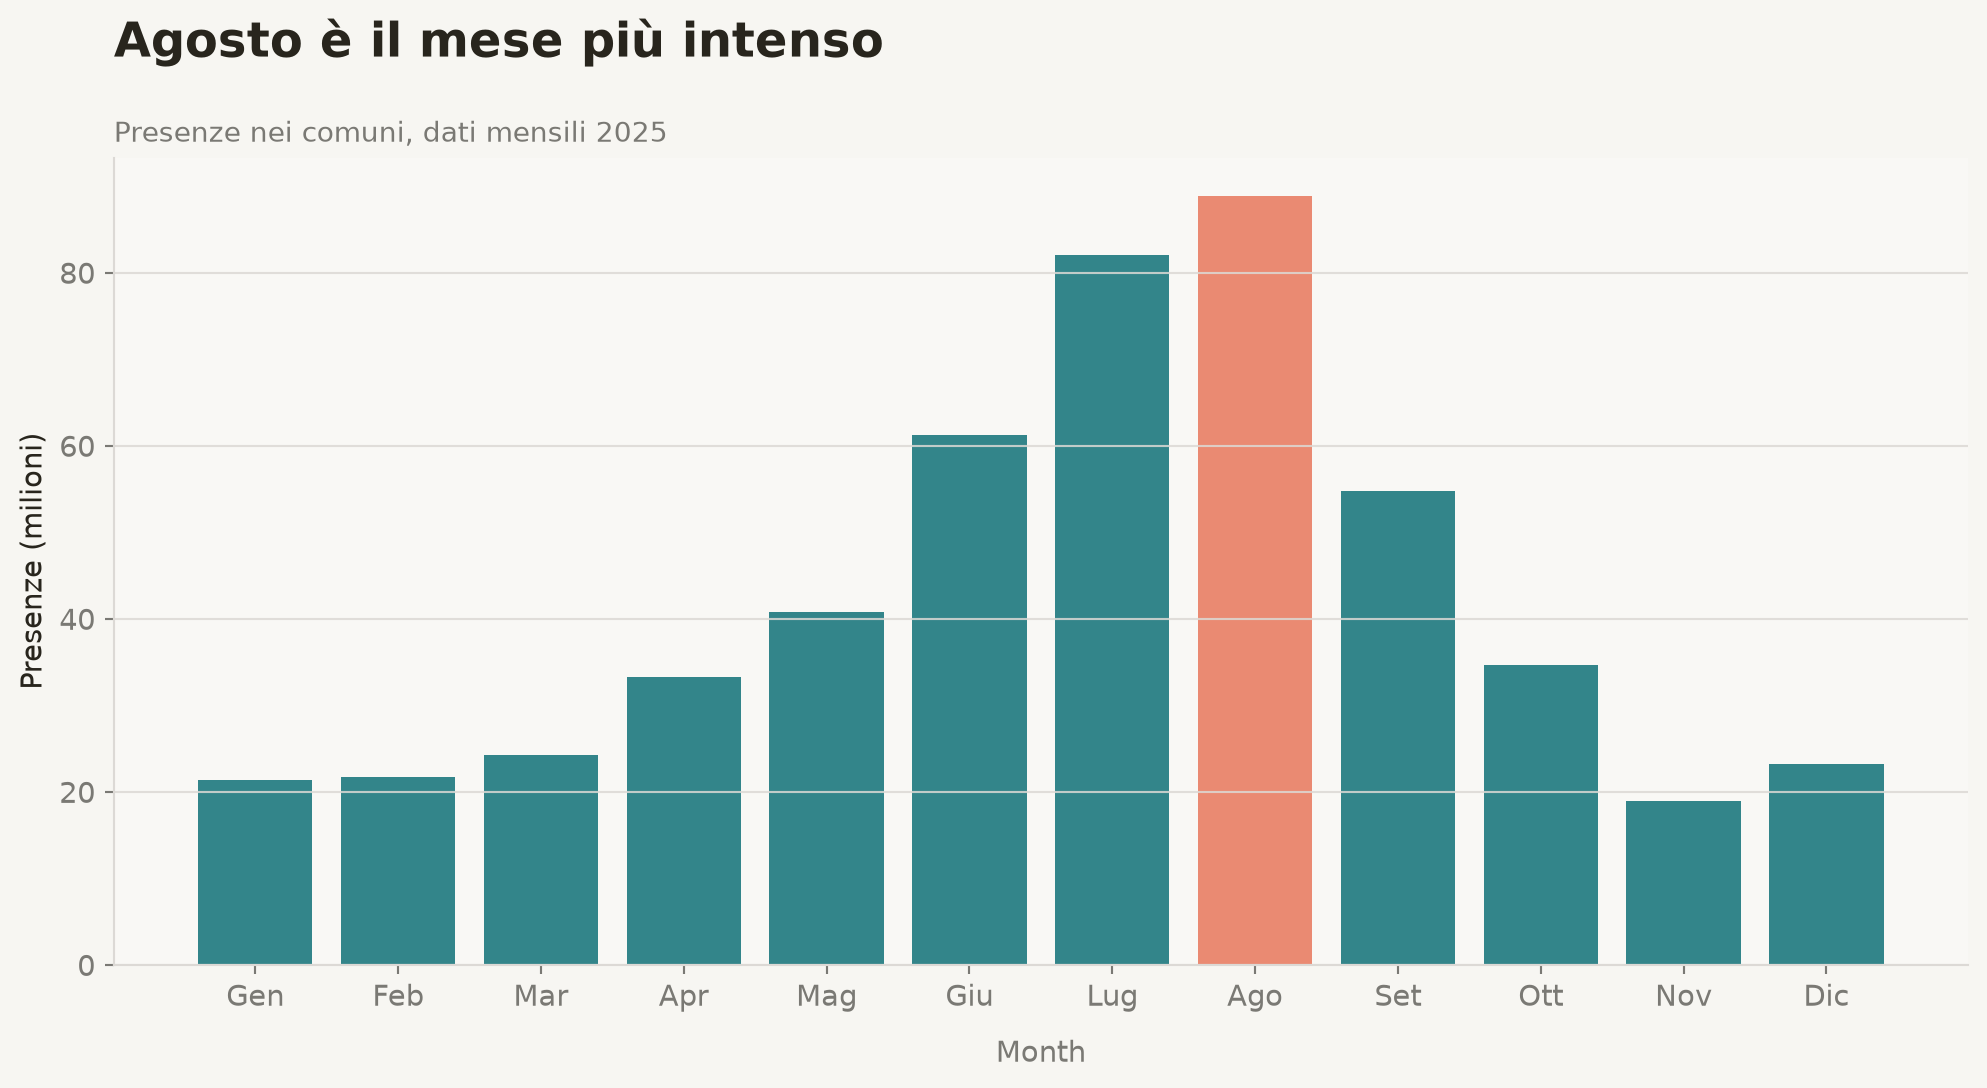
**Il turismo italiano è stagionale?** Moltissimo. Agosto rappresenta circa il 17,6% delle presenze registrate nel file comunale mensile del 2025; anche luglio e settembre hanno un peso rilevante.
L'obiettivo di questo articolo non è produrre un unico “punteggio del turismo”. È mostrare come alcuni accorgimenti di ristrutturazione e controllo possano trasformare file ufficiali in un'analisi coerente e verificabile.
# Caricare i file ISTAT
Per rispondere a queste domande ho usato tre file ISTAT. Descrivono il turismo italiano a diversi livelli di dettaglio e ciascuno è utile per una parte diversa dell'analisi:
- `1_serie_storica.xlsx`: arrivi e presenze in Italia dal 1956 al 2025
- `3_dati_provinciali_per_provenienza.xlsx`: turismo per provincia e Paese di residenza degli ospiti dal 2019 al 2025
- `2_dati_comunali.xlsx`: dati annuali per comune dal 2014 al 2025 e dati mensili comunali dal 2022 al 2025
I file non usano esattamente la stessa struttura né la stessa unità di misura. Il file storico riporta valori in migliaia, mentre i file provinciali e comunali riportano arrivi e presenze come conteggi individuali. Ho mantenuto esplicita questa distinzione durante tutta l'analisi, invece di convertire subito ogni valore e rischiare di confondere le serie.
Prima di esaminare i risultati ho dovuto pulire i file, assegnare nomi chiari alle colonne e ristrutturare alcune tabelle molto ampie in un formato più facile da analizzare.
```{python}
#| code-fold: true
#| code-summary: "Mostra importazioni e stile visuale"
from pathlib import Path

import matplotlib.pyplot as plt
from matplotlib.ticker import FuncFormatter, MaxNLocator
import numpy as np
import pandas as pd
import plotly.graph_objects as go

HISTORICAL_FILE = Path("1_serie_storica.xlsx")
PROVINCIAL_FILE = Path("3_dati_provinciali_per_provenienza.xlsx")
MUNICIPAL_FILE = Path("2_dati_comunali.xlsx")

BG = "#f7f6f2"
PANEL = "#f9f8f5"
TEXT = "#28251d"
MUTED = "#7a7974"
GRID = "#dcd9d5"
TEAL = "#01696f"
CORAL = "#e76f51"

COUNTRY_EN = {
    "Germania": "Germania", "Stati Uniti d'America": "Stati Uniti",
    "Francia": "Francia", "Regno Unito": "Regno Unito",
    "Svizzera e Liechtenstein": "Svizzera e Liechtenstein",
    "Paesi Bassi": "Paesi Bassi", "Polonia": "Polonia", "Austria": "Austria",
    "Spagna": "Spagna", "Belgio": "Belgio", "Canada": "Canada",
    "Australia": "Australia", "Brasile": "Brasile", "Israele": "Israele",
    "India": "India", "Cina": "Cina", "Giappone": "Giappone",
    "Nuova Zelanda": "Nuova Zelanda", "Turchia": "Turchia", "Russia": "Russia",
    "Danimarca": "Danimarca", "Svezia": "Svezia", "Norvegia": "Norvegia",
    "Finlandia": "Finlandia", "Irlanda": "Irlanda", "Portogallo": "Portogallo",
    "Grecia": "Grecia", "Repubblica Ceca": "Cechia", "Romania": "Romania",
}

PROVINCE_EN = {
    "Bolzano-Bozen": "Bolzano", "Venezia": "Venezia", "Milano": "Milano",
    "Roma": "Roma", "Firenze": "Firenze", "Napoli": "Napoli",
    "Torino": "Torino", "Sassari": "Sassari", "Livorno": "Livorno",
    "Brescia": "Brescia", "Verona": "Verona", "Trento": "Trento",
    "Rimini": "Rimini", "Como": "Como", "Siena": "Siena", "Palermo": "Palermo",
    "Udine": "Udine",
}

plt.rcParams.update({
    "figure.facecolor": BG,
    "axes.facecolor": PANEL,
    "axes.edgecolor": GRID,
    "axes.labelcolor": TEXT,
    "axes.titlecolor": TEXT,
    "xtick.color": MUTED,
    "ytick.color": MUTED,
    "text.color": TEXT,
    "font.size": 11,
    "axes.titlesize": 18,
    "axes.titleweight": "bold",
    "legend.frameon": False,
})
pd.options.display.float_format = "{:,.2f}".format
```
## Dai layout Excel estesi alle tabelle ordinate
La prima difficoltà — come spesso accade nell'EDA — non è stata analizzare i dati, ma leggerli correttamente. I tre file sono stati costruiti per la pubblicazione e non per l'analisi: hanno strutture di intestazione diverse, livelli di dettaglio differenti e diverse colonne da interpretare prima dell'utilizzo.
Per esempio, la serie storica ha due righe di intestazione prima dell'inizio dei dati effettivi. I file provinciali e comunali contengono invece blocchi estesi di colonne suddivisi per tipo di struttura, residenza dell'ospite o mese. Ho scritto una piccola funzione di parsing per ciascun file, così che queste scelte fossero esplicite e non nascoste in un unico lungo passaggio di pulizia.
```{python}
#| code-fold: true
#| code-summary: "Mostra le funzioni di parsing dei file"
def read_historical(path):
    raw = pd.read_excel(path, header=None).iloc[6:, :19].copy()
    raw.columns = [
        "year", "arrivals_residents", "arrivals_non_residents", "arrivals_total",
        "arrivals_hotels_residents", "arrivals_hotels_non_residents", "arrivals_hotels_total",
        "arrivals_other_residents", "arrivals_other_non_residents", "arrivals_other_total",
        "nights_residents", "nights_non_residents", "nights_total",
        "nights_hotels_residents", "nights_hotels_non_residents", "nights_hotels_total",
        "nights_other_residents", "nights_other_non_residents", "nights_other_total",
    ]
    raw["year"] = pd.to_numeric(raw["year"].astype(str).str.extract(r"(\d{4})")[0], errors="coerce")
    for col in raw.columns[1:]:
        raw[col] = pd.to_numeric(raw[col], errors="coerce")
    return raw.dropna(subset=["year", "arrivals_total", "nights_total"]).astype({"year": int})


def read_provincial(path):
    raw = pd.read_excel(path, header=None).iloc[2:, :21].copy()
    raw.columns = [
        "year", "region_code", "region", "province_code", "province",
        "country_code", "country", *[f"accommodation_{i}" for i in range(14)],
    ]
    data = raw[["year", "region", "province_code", "province", "country_code", "country",
                "accommodation_12", "accommodation_13"]].copy()
    data.columns = ["year", "region", "province_code", "province", "country_code", "country",
                    "arrivals", "nights"]
    data["year"] = pd.to_numeric(data["year"], errors="coerce")
    data["province_code"] = (data["province_code"].astype("string")
                              .str.replace(r"\.0$", "", regex=True)
                              .str.zfill(3))
    data["country_code"] = pd.to_numeric(data["country_code"], errors="coerce")
    data["arrivals"] = pd.to_numeric(data["arrivals"], errors="coerce")
    data["nights"] = pd.to_numeric(data["nights"], errors="coerce")
    data = data.dropna(subset=["year", "country_code", "province", "country", "arrivals", "nights"])
    data["year"] = data["year"].astype(int)
    data[["arrivals", "nights"]] = data[["arrivals", "nights"]].round().astype("Int64")
    return data


def read_municipal_annual(path):
    raw = pd.read_excel(path, sheet_name=0, header=None).iloc[6:, :].copy()
    data = pd.DataFrame({
        "year": pd.to_numeric(raw.iloc[:, 0], errors="coerce"),
        "region": raw.iloc[:, 2].astype("string").str.strip(),
        "province": raw.iloc[:, 4].astype("string").str.strip(),
        "municipality": raw.iloc[:, 5].astype("string").str.strip(),
        "arrivals_residents": pd.to_numeric(raw.iloc[:, 8], errors="coerce"),
        "arrivals_non_residents": pd.to_numeric(raw.iloc[:, 9], errors="coerce"),
        "arrivals": pd.to_numeric(raw.iloc[:, 10], errors="coerce"),
        "nights_residents": pd.to_numeric(raw.iloc[:, 17], errors="coerce"),
        "nights_non_residents": pd.to_numeric(raw.iloc[:, 18], errors="coerce"),
        "nights": pd.to_numeric(raw.iloc[:, 19], errors="coerce"),
    })
    data = data.dropna(subset=["year", "municipality", "arrivals", "nights"]).astype({"year": int})
    count_columns = [column for column in data if column.startswith(("arrivals", "nights"))]
    data[count_columns] = data[count_columns].round().astype("Int64")
    return data


def read_municipal_monthly(path):
    raw = pd.read_excel(path, sheet_name=1, header=None).iloc[4:, :].copy()
    data = pd.DataFrame({
        "year": pd.to_numeric(raw.iloc[:, 0], errors="coerce"),
        "province": raw.iloc[:, 4].astype("string").str.strip(),
        "municipality": raw.iloc[:, 5].astype("string").str.strip(),
        **{f"arrivals_{m:02d}": pd.to_numeric(raw.iloc[:, 8 + m - 1], errors="coerce") for m in range(1, 13)},
        **{f"nights_{m:02d}": pd.to_numeric(raw.iloc[:, 20 + m - 1], errors="coerce") for m in range(1, 13)},
    })
    data = data.dropna(subset=["year", "municipality"]).astype({"year": int})
    count_columns = [column for column in data if column.startswith(("arrivals", "nights"))]
    data[count_columns] = data[count_columns].fillna(0).round().astype("Int64")
    return data


historical = read_historical(HISTORICAL_FILE)
provincial = read_provincial(PROVINCIAL_FILE)
municipal_annual = read_municipal_annual(MUNICIPAL_FILE)
municipal_monthly = read_municipal_monthly(MUNICIPAL_FILE)

historical.agg(start_year=("year", "min"), end_year=("year", "max"), rows=("year", "size"))
```
La tabella storica principale contiene 66 osservazioni annuali dal 1956 al 2025. La riga del 2025 è indicata come provvisoria nella fonte e introduce anche un cambiamento di definizione: da quell'anno gli altri alloggi in affitto privato sono inclusi nei dati sui flussi turistici. Per questo uso il 2024 quando confronto la serie lunga con il periodo pre-pandemico e indico il 2025 come provvisorio ogni volta che compare.
# Il quadro di lungo periodo: il turismo è diventato molto più grande
Ho iniziato dalle presenze, invece che dagli arrivi. Gli arrivi indicano quanti viaggi sono stati effettuati, ma le presenze descrivono meglio la pressione e la dimensione effettiva del turismo: una persona che soggiorna una notte e una famiglia che trascorre due settimane non dovrebbero pesare allo stesso modo.
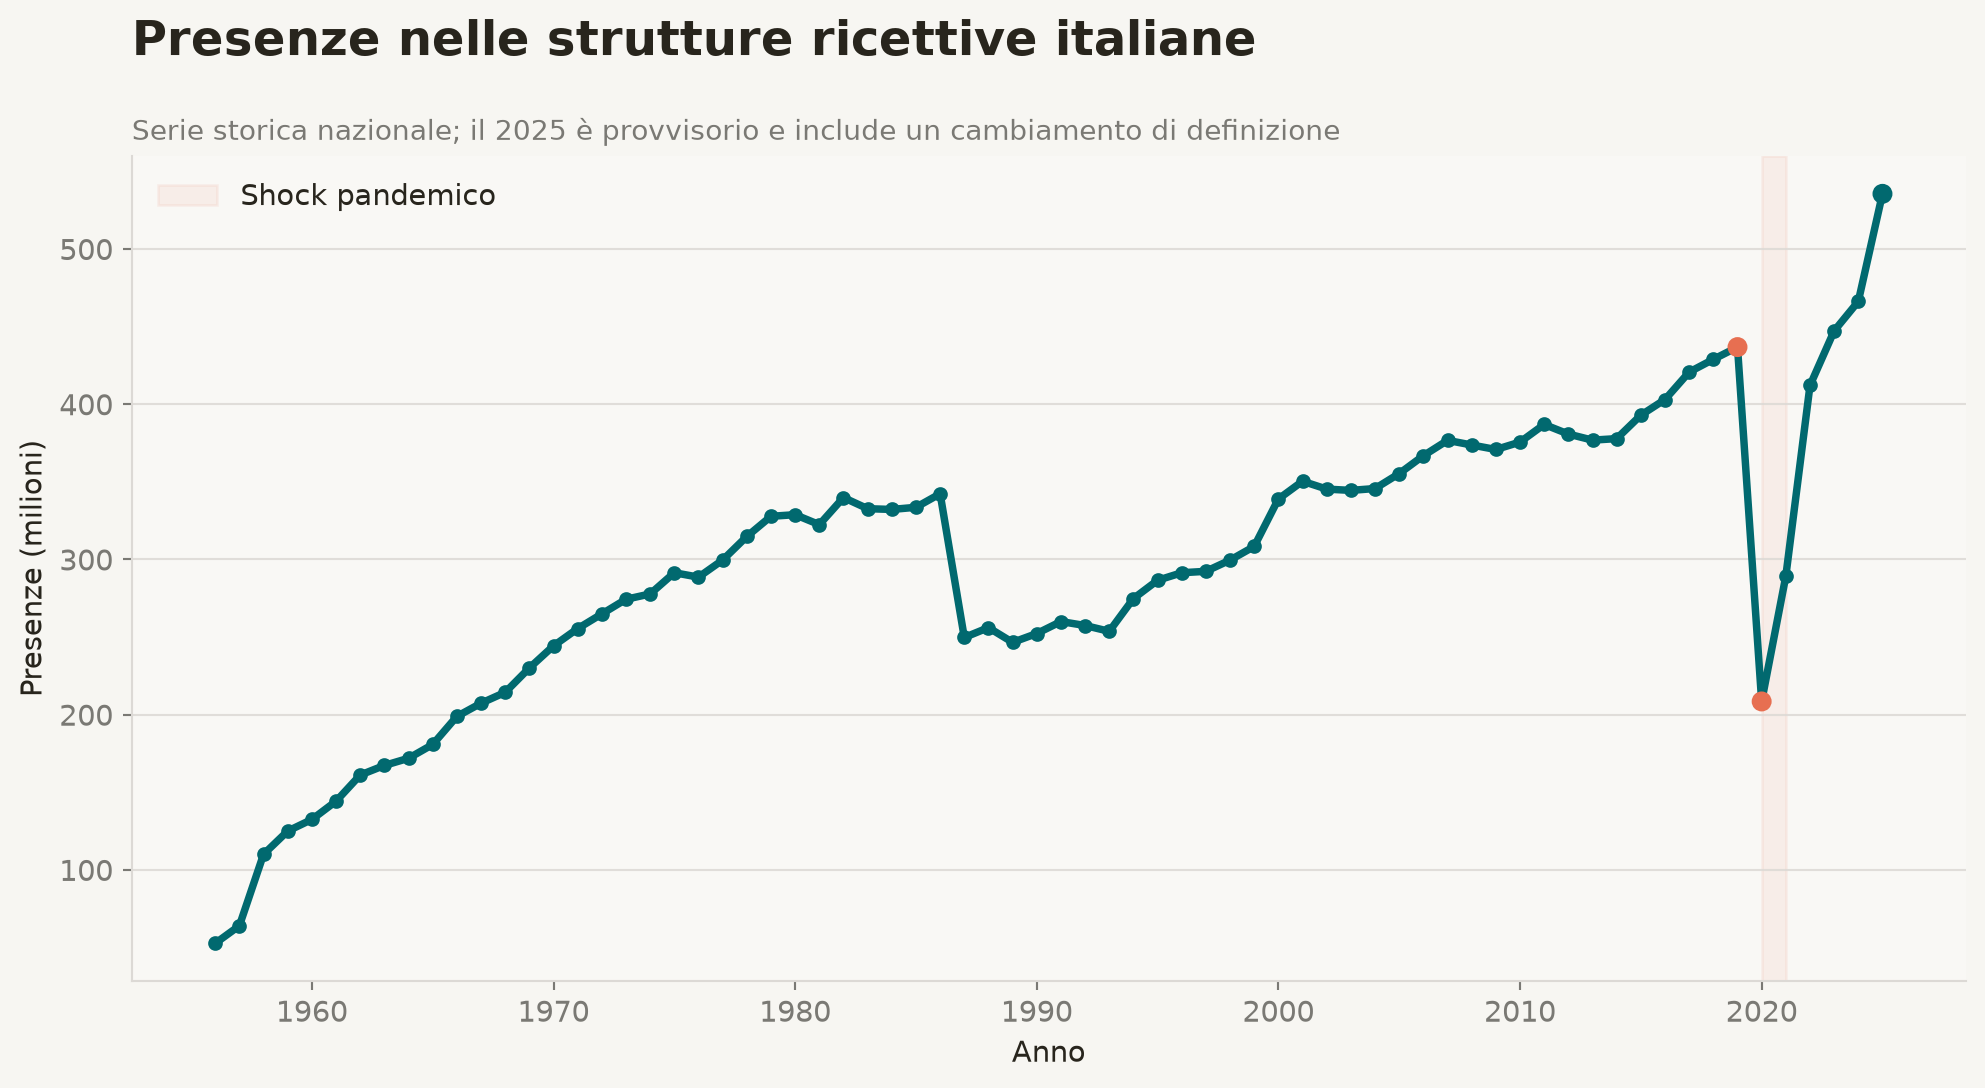
Il grafico seguente mostra il numero totale di presenze nelle strutture ricettive italiane tra il 1956 e il 2025.
```{python}
#| code-fold: true
#| code-summary: "Mostra il codice del grafico di lungo periodo"
history_plot = historical.copy()
history_plot["nights_millions"] = history_plot["nights_total"] / 1_000

fig, ax = plt.subplots(figsize=(10.5, 5.8))
ax.plot(history_plot["year"], history_plot["nights_millions"], color=TEAL, linewidth=2.8, marker="o", markersize=4.5, zorder=2)
ax.scatter([2019, 2020, 2025], history_plot.set_index("year").loc[[2019, 2020, 2025], "nights_millions"],
           color=[CORAL, CORAL, TEAL], s=42, zorder=3)
ax.axvspan(2020, 2021, color=CORAL, alpha=0.08, label="Shock pandemico")
ax.set_title("Presenze nelle strutture ricettive italiane", loc="left", pad=38)
ax.text(0, 1.02, "Serie storica nazionale; il 2025 è provvisorio e include un cambiamento di definizione", transform=ax.transAxes, fontsize=10.5, color=MUTED)
ax.set_xlabel("Anno")
ax.set_ylabel("Presenze (milioni)")
ax.grid(axis="y", color=GRID, linewidth=0.8, alpha=0.85)
ax.grid(axis="x", visible=False)
ax.xaxis.set_major_locator(MaxNLocator(integer=True, nbins=9))
ax.legend(loc="upper left")
for spine in ["top", "right"]:
    ax.spines[spine].set_visible(False)
ax.spines["left"].set_color(GRID)
ax.spines["bottom"].set_color(GRID)
plt.tight_layout()
plt.show()
```
La direzione generale è chiara: il turismo italiano è cresciuto enormemente negli ultimi settant'anni. Le presenze sono aumentate da 52,6 milioni nel 1956 a 436,7 milioni nel 2019. Il dato provvisorio del 2025 raggiunge 535,5 milioni.
Ma non è una semplice storia di crescita. La serie include cambiamenti nella classificazione delle strutture, una discontinuità evidente alla fine degli anni Ottanta e il crollo improvviso causato dalla pandemia nel 2020.
## Che cosa è successo intorno al 1987?
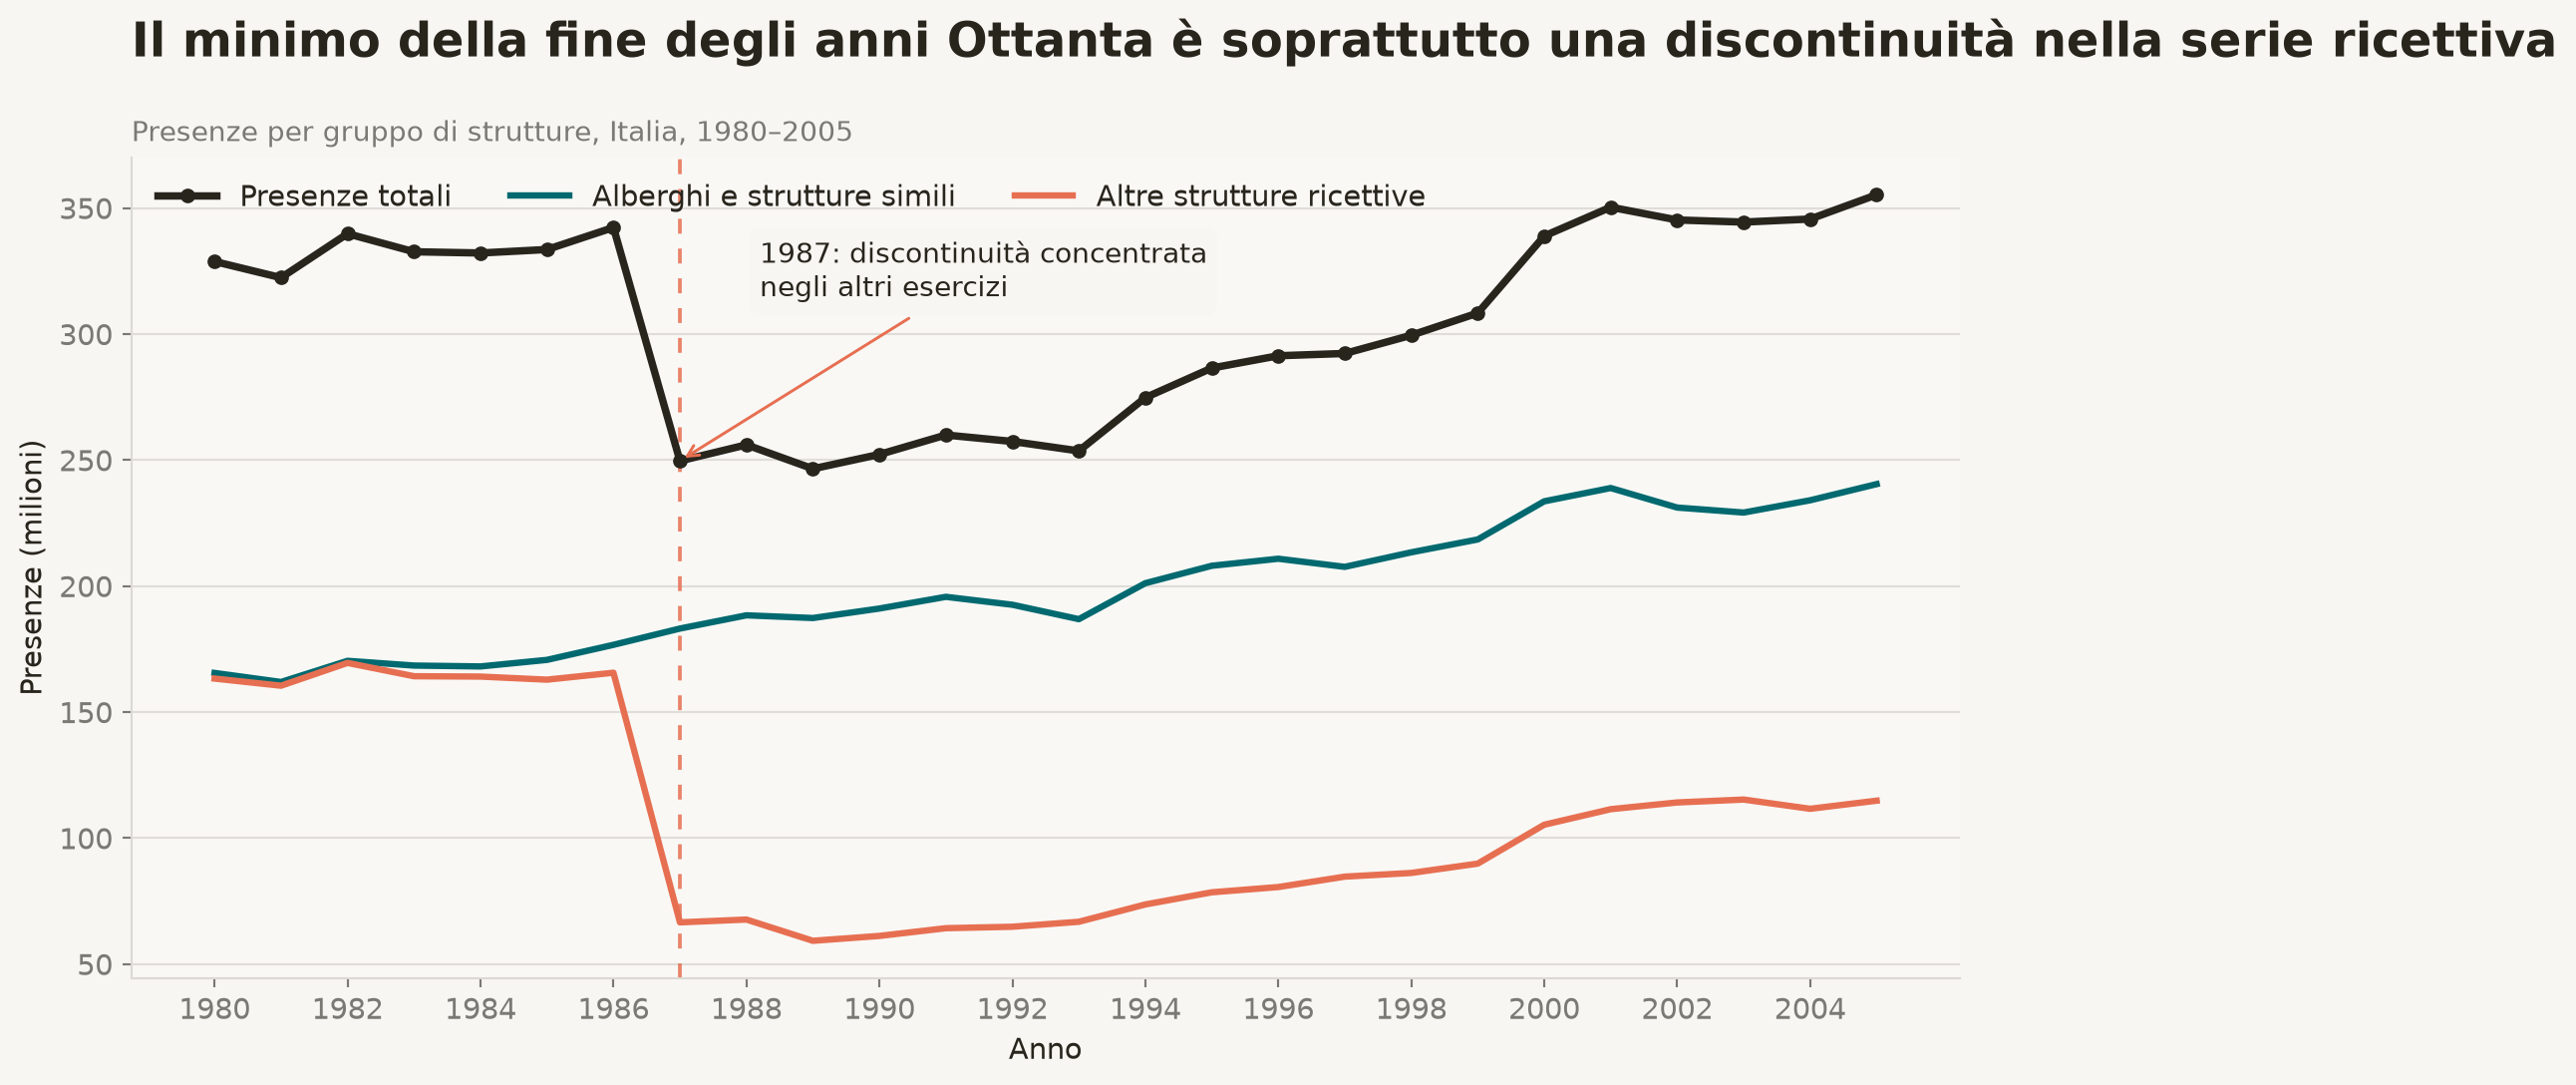
Il calo intorno al 1987 ha attirato subito la mia attenzione. Le presenze totali scendono da 342,3 milioni nel 1986 a 249,7 milioni nel 1987: sembra un crollo del 27,1% in un solo anno.
Nello stesso periodo, però, gli arrivi diminuiscono solo del 5,3%. Anche la durata media del soggiorno scende, da 5,94 a 4,57 notti, ma non abbastanza da spiegare interamente una simile caduta delle presenze. Questo fa pensare che la discontinuità riguardi almeno in parte definizioni e classificazioni, più che una scomparsa improvvisa dei turisti.
```{python}
#| code-fold: true
#| code-summary: "Mostra il codice del grafico sulla fine degli anni Ottanta"
late_eighties = historical.loc[historical["year"].between(1980, 2005)].copy()
for column in ["nights_total", "nights_hotels_total", "nights_other_total"]:
    late_eighties[column + "_millions"] = late_eighties[column] / 1_000

fig, ax = plt.subplots(figsize=(10.5, 5.8))
ax.plot(late_eighties["year"], late_eighties["nights_total_millions"], color=TEXT, linewidth=2.8, marker="o", markersize=4.5, label="Presenze totali", zorder=3)
ax.plot(late_eighties["year"], late_eighties["nights_hotels_total_millions"], color=TEAL, linewidth=2.4, label="Alberghi e strutture simili")
ax.plot(late_eighties["year"], late_eighties["nights_other_total_millions"], color=CORAL, linewidth=2.4, label="Altre strutture ricettive")
ax.axvline(1987, color=CORAL, linestyle=(0, (4, 4)), linewidth=1.4, alpha=0.85)
ax.annotate("1987: discontinuità concentrata\nnegli altri esercizi", xy=(1987, 249.7), xytext=(1988.2, 315),
            arrowprops=dict(arrowstyle="->", color=CORAL, linewidth=1.1), color=TEXT, fontsize=10.5,
            bbox=dict(boxstyle="round,pad=0.35", facecolor=BG, edgecolor="none", alpha=0.92))
ax.set_title("Il minimo della fine degli anni Ottanta è soprattutto una discontinuità nella serie ricettiva", loc="left", pad=38)
ax.text(0, 1.02, "Presenze per gruppo di strutture, Italia, 1980–2005", transform=ax.transAxes, fontsize=10.5, color=MUTED)
ax.set_xlabel("Anno")
ax.set_ylabel("Presenze (milioni)")
ax.set_xticks(late_eighties["year"][::2])
ax.grid(axis="y", color=GRID, linewidth=0.8, alpha=0.85)
ax.grid(axis="x", visible=False)
for spine in ["top", "right"]:
    ax.spines[spine].set_visible(False)
ax.spines["left"].set_color(GRID)
ax.spines["bottom"].set_color(GRID)
ax.legend(loc="upper left", ncol=3)
plt.tight_layout()
plt.show()
```
La suddivisione per tipo di struttura chiarisce meglio il problema. Le presenze alberghiere aumentano leggermente, da 176,7 a 183,1 milioni, mentre quelle negli “altri esercizi ricettivi” scendono da 165,6 a 66,5 milioni.
ISTAT segnala un cambiamento di classificazione in questo periodo: dal 1986 le residenze turistico-alberghiere passano dagli esercizi extra-alberghieri a quelli alberghieri. Tuttavia, questa nota non spiega completamente il calo della serie totale, perché il totale dovrebbe continuare a includere entrambi i gruppi di strutture.
La mia interpretazione è che la discontinuità del 1987 combini una reale riduzione della durata media del soggiorno con una rottura nella comparabilità dei dati sulle strutture. Eviterei quindi di descriverla come un crollo del 27% della domanda turistica. È più corretto considerarla come il punto in cui la serie storica diventa meno direttamente comparabile.
Dopo il 1987, le presenze totali rimangono intorno a 250–300 milioni per gran parte degli anni Novanta e tornano ai livelli del 1986 solo intorno al 2000–2001. Gli arrivi recuperano prima: questo suggerisce che la ripresa più lenta delle presenze dipendesse soprattutto da soggiorni più brevi e da cambiamenti nella composizione delle strutture, non semplicemente da un minor numero di persone in viaggio verso l'Italia.
## La pandemia è stata uno shock, non una nuova normalità
La lunga serie storica mostra la dimensione del crollo del 2020, ma il file provinciale offre una visione più dettagliata di ciò che è accaduto durante la ripresa. A differenza della serie storica, questi dati sono riportati come conteggi individuali e non in migliaia.
Per calcolare i totali nazionali da questo file ho selezionato le righe con il totale provinciale (`country_code == 0`) e le ho sommate tra le province. Ho mantenuto separati i singoli Paesi esteri, così da non contare due volte le righe aggregate.
```{python}
prov_total = (
    provincial[provincial["country_code"].eq(0)]
    .groupby("year", as_index=False)[["arrivals", "nights"]].sum()
)
prov_total["average_stay"] = prov_total["nights"] / prov_total["arrivals"]
prov_total["nights_millions"] = prov_total["nights"] / 1_000_000
prov_total["change_vs_2019"] = prov_total["nights"] / prov_total.loc[prov_total.year.eq(2019), "nights"].iloc[0] - 1
prov_total
```
```{python}
#| code-fold: true
#| code-summary: "Mostra il codice del grafico della ripresa"
fig, ax = plt.subplots(figsize=(10.5, 5.8))
ax.plot(prov_total["year"], prov_total["nights_millions"], color=TEAL, linewidth=2.8, marker="o", markersize=5.5)
ax.axhline(prov_total.loc[prov_total.year.eq(2019), "nights_millions"].iloc[0], color=MUTED, linestyle=(0, (4, 4)), linewidth=1.4, label="Livello 2019")
ax.set_title("La ripresa post-pandemica ha superato il precedente picco", loc="left", pad=38)
ax.text(0, 1.02, "Presenze annuali, sommate tra le province italiane", transform=ax.transAxes, fontsize=10.5, color=MUTED)
ax.set_xlabel("Anno")
ax.set_ylabel("Presenze (milioni)")
ax.set_xticks(prov_total["year"])
ax.grid(axis="y", color=GRID, linewidth=0.8, alpha=0.85)
ax.grid(axis="x", visible=False)
ax.legend(loc="upper left")
for spine in ["top", "right"]:
    ax.spines[spine].set_visible(False)
ax.spines["left"].set_color(GRID)
ax.spines["bottom"].set_color(GRID)
plt.tight_layout()
plt.show()
```
La ripresa ha cambiato anche la composizione dei visitatori. I residenti all'estero rappresentavano circa il 50,5% delle presenze nel 2019, sono scesi al 31,4% nel 2020 e hanno raggiunto il 54,5% nel 2024 nella serie storica. Il rimbalzo appare quindi meno come un semplice ritorno della domanda interna e più come la riapertura del circuito turistico internazionale italiano.
# Dove si concentrano le presenze
I totali provinciali mostrano una geografia concentrata: un piccolo gruppo di destinazioni raccoglie una quota rilevante del mercato nazionale. La classifica non è solo una classifica delle grandi città. Include anche sistemi turistici e province la cui capacità ricettiva serve un intero territorio — le Dolomiti, la laguna veneta, il Lago di Garda o l'area metropolitana romana.
```{python}
latest_provinces = (
    provincial.query("year == 2025 and country_code == 0")
    .nlargest(10, "nights")[["province", "nights", "arrivals"]]
    .assign(nights_millions=lambda d: d["nights"] / 1_000_000)
)
latest_provinces["province_en"] = (
    latest_provinces["province"].astype("string").str.strip().str.title()
    .map(PROVINCE_EN).fillna(latest_provinces["province"])
)
latest_provinces = latest_provinces.drop(columns="province")
latest_provinces = latest_provinces.rename(columns={"province_en": "province"})
latest_provinces = latest_provinces[["province"] + [col for col in latest_provinces.columns if col != "province"]]
latest_provinces
```
```{python}
fig, ax = plt.subplots(figsize=(10.5, 5.8))
plot_data = latest_provinces.sort_values("nights_millions")
ax.barh(plot_data["province"], plot_data["nights_millions"], color=TEAL, alpha=0.8, edgecolor="none", height=0.65)
ax.set_title("Le dieci province con più presenze nel 2025", loc="left", pad=38)
ax.text(0, 1.02, "Provisional provincial totals; English labels used for readability", transform=ax.transAxes, fontsize=10.5, color=MUTED)
ax.set_xlabel("Presenze (milioni)", color=MUTED, fontsize=11, labelpad=10)
ax.grid(axis="x", color=GRID, linewidth=0.8, alpha=0.85)
ax.grid(axis="y", visible=False)
for spine in ["top", "right", "left"]:
    ax.spines[spine].set_visible(False)
ax.spines["bottom"].set_color(GRID)
plt.tight_layout()
plt.show()
```
Rome led the 2025 provincial table with 56.0 million nights, followed by Venice and Bolzano. The municipal table provides a useful cross-check: it puts Rome, Milan, Venice, and Florence at the top when the analysis is performed at destination-municipality level. The small difference between the provincial and municipal totals is a reminder that official tables can have different coverage and disclosure rules; they should be compared as complementary views, not mechanically stacked together.
# Chi visita l'Italia?
La tabella della residenza è particolarmente utile perché trasforma il “turismo internazionale” in un insieme di flussi visibili. Il grafico seguente esclude `TOTALE`, le regioni italiane e gli altri codici aggregati, poi classifica le singole residenze estere in base alle presenze nel 2025.
```{python}
foreign_2025 = provincial.query("year == 2025 and country_code.between(1, 887)")
top_markets = (
    foreign_2025.groupby("country", as_index=False)[["arrivals", "nights"]].sum()
    .nlargest(12, "nights")
    .assign(nights_millions=lambda d: d["nights"] / 1_000_000)
)
top_markets["country_en"] = top_markets["country"].map(COUNTRY_EN).fillna(top_markets["country"])
top_markets = top_markets.drop(columns="country")
top_markets = top_markets.rename(columns={"country_en": "country"})
top_markets = top_markets[["country"] + [col for col in top_markets.columns if col != "country"]]
top_markets
```
```{python}
fig, ax = plt.subplots(figsize=(10.5, 5.8))
plot_data = top_markets.sort_values("nights_millions")
ax.barh(plot_data["country"], plot_data["nights_millions"], color=CORAL, alpha=0.8, edgecolor="none", height=0.65)
ax.set_title("La Germania è il principale mercato turistico estero dell'Italia", loc="left", pad=38)
ax.text(0, 1.02, "Top foreign residences by nights spent, 2025 provisional provincial data", transform=ax.transAxes, fontsize=10.5, color=MUTED)
ax.set_xlabel("Presenze (milioni)", color=MUTED, fontsize=11, labelpad=10)
ax.grid(axis="x", color=GRID, linewidth=0.8, alpha=0.85)
ax.grid(axis="y", visible=False)
for spine in ["top", "right", "left"]:
    ax.spines[spine].set_visible(False)
ax.spines["bottom"].set_color(GRID)
plt.tight_layout()
plt.show()
```
La Germania ha contribuito con 71,0 milioni di presenze nel file provinciale del 2025, più del doppio del totale degli Stati Uniti. La classifica è una descrizione utile della domanda, non una misura del valore o della redditività di ciascun mercato: durata media, tipo di struttura, spesa e geografia differiscono da un Paese all'altro.
# Agosto domina ancora il calendario
I totali annuali nascondono il ritmo operativo del turismo. Il file comunale mensile copre il periodo 2022–2025; filtrarlo sul 2025 e sommare le dodici colonne mensili mostra quanto la domanda sia concentrata in estate.
```{python}
monthly_2025 = municipal_monthly.query("year == 2025").copy()
monthly_nights = pd.Series({
    month: monthly_2025[f"nights_{month:02d}"].sum()
    for month in range(1, 13)
})
monthly_nights.index = ["Gen", "Feb", "Mar", "Apr", "Mag", "Giu", "Lug", "Ago", "Set", "Ott", "Nov", "Dic"]
monthly_nights = monthly_nights / 1_000_000
monthly_nights.to_frame("nights_millions")
```
```{python}
#| code-fold: true
#| code-summary: "Show the monthly seasonality chart code"
fig, ax = plt.subplots(figsize=(10.5, 5.8))
colors = [CORAL if month == "Ago" else TEAL for month in monthly_nights.index]
ax.bar(monthly_nights.index, monthly_nights, color=colors, alpha=0.8, edgecolor="none")
ax.set_title("Agosto è il mese più intenso", loc="left", pad=38)
ax.text(0, 1.02, "Presenze nei comuni, dati mensili 2025", transform=ax.transAxes, fontsize=10.5, color=MUTED)
ax.set_xlabel("Month", color=MUTED, fontsize=11, labelpad=10)
ax.set_ylabel("Presenze (milioni)")
ax.grid(axis="y", color=GRID, linewidth=0.8, alpha=0.85)
ax.grid(axis="x", visible=False)
for spine in ["top", "right"]:
    ax.spines[spine].set_visible(False)
ax.spines["left"].set_color(GRID)
ax.spines["bottom"].set_color(GRID)
plt.tight_layout()
plt.show()
```
Agosto rappresenta circa il 17,6% delle presenze nel file comunale mensile del 2025. Luglio e settembre aggiungono un altro blocco consistente, con conseguenze per trasporti, personale, consumo d'acqua, pressione abitativa e impronta ambientale delle destinazioni. Un totale nazionale annuale è quindi solo l'inizio della questione di pianificazione.
# Leggere i flussi: dalla residenza alla destinazione
I grafici precedenti classificano luoghi e mercati separatamente. Le due viste seguenti mantengono visibile la relazione tra loro. Per prima cosa, un diagramma di Sankey mostra come le principali residenze estere si colleghino alle province italiane più importanti nel 2025. I colori seguono la palette dell'articolo: il corallo identifica i mercati di origine e il verde petrolio le destinazioni italiane.
```{python}
#| code-fold: true
#| code-summary: "Mostra il codice del diagramma di Sankey"
SANKey_YEAR = 2025
TOP_COUNTRIES = 12
TOP_PROVINCES = 15
MIN_PRESENCES = 1_000

flow_data = provincial.query(
    "year == @SANKey_YEAR and country_code.between(1, 887) and nights >= @MIN_PRESENCES"
).copy()
flow_data["country"] = flow_data["country"].astype(str).str.strip()
flow_data["province"] = flow_data["province"].astype(str).str.strip().str.title()
flow_data = (
    flow_data.groupby(["country_code", "country", "province"], as_index=False)
    .agg(arrivals=("arrivals", "sum"), nights=("nights", "sum"))
)

top_countries_flow = (
    flow_data.groupby(["country_code", "country"], as_index=False)["nights"]
    .sum()
    .nlargest(TOP_COUNTRIES, "nights")
)
top_provinces_flow = (
    flow_data.groupby("province", as_index=False)["nights"]
    .sum()
    .nlargest(TOP_PROVINCES, "nights")
)
flow_data = flow_data.merge(top_countries_flow[["country_code", "country"]], on=["country_code", "country"])
flow_data = flow_data.merge(top_provinces_flow[["province"]], on="province")

province_coordinates = {
    "Bolzano-Bozen": (46.4983, 11.3548), "Verona": (45.4385, 10.9938),
    "Livorno": (43.5443, 10.3262), "Brescia": (45.5356, 10.2147),
    "Udine": (46.0711, 13.2346),
    "Torino": (45.0703, 7.6869),
    "Venezia": (45.4333, 12.3500), "Trento": (46.0667, 11.1333),
    "Rimini": (44.0667, 12.5667), "Sassari": (40.7167, 8.5667),
    "Como": (45.8000, 9.0833), "Siena": (43.3167, 11.3000),
    "Palermo": (38.1166, 13.3636), "Milano": (45.4643, 9.1895),
    "Napoli": (40.8522, 14.2681), "Roma": (41.9000, 12.4833),
    "Firenze": (43.7667, 11.2500),
}

province_totals_flow = flow_data.groupby("province", as_index=False)["nights"].sum()
missing_provinces = sorted(set(province_totals_flow["province"]) - set(province_coordinates))
if missing_provinces:
    raise ValueError(f"Missing coordinates for Sankey provinces: {missing_provinces}")

country_totals_flow = (
    flow_data.groupby(["country_code", "country"], as_index=False)["nights"]
    .sum()
    .sort_values("nights", ascending=False)
    .reset_index(drop=True)
)
province_totals_flow = province_totals_flow.assign(
    latitude=province_totals_flow["province"].map(lambda p: province_coordinates[p][0])
).sort_values(["latitude", "province"], ascending=[False, True]).reset_index(drop=True)

ISO2_BY_NUMERIC = {
    1: "FR", 3: "NL", 4: "DE", 6: "GB", 7: "IE", 8: "DK", 9: "GR", 10: "PT", 11: "ES",
    17: "BE", 18: "LU", 24: "IS", 28: "NO", 30: "SE", 32: "FI", 36: "CH", 38: "AT",
    52: "TR", 55: "LT", 60: "PL", 61: "CZ", 63: "SK", 64: "HU", 66: "RO", 68: "BG",
    72: "UA", 75: "RU", 400: "US", 404: "CA", 508: "BR", 624: "IL", 664: "IN",
    720: "CN", 732: "JP", 800: "AU", 804: "NZ",
}

def flag(iso2):
    if not iso2 or len(iso2) != 2:
        return "🌍"
    return "".join(chr(127397 + ord(c)) for c in iso2.upper())


country_nodes = [
    f"{flag(ISO2_BY_NUMERIC.get(int(row.country_code)))} {COUNTRY_EN.get(row.country, row.country)}"
    for row in country_totals_flow.itertuples(index=False)
]
province_nodes = [f"🇮🇹 {PROVINCE_EN.get(p, p)}" for p in province_totals_flow["province"]]
labels = country_nodes + province_nodes
country_y = np.linspace(0.03, 0.97, len(country_nodes))
province_y = np.linspace(0.03, 0.97, len(province_nodes))
node_x = [0.01] * len(country_nodes) + [0.99] * len(province_nodes)
node_y = country_y.tolist() + province_y.tolist()

country_index = {
    (int(row.country_code), row.country): i
    for i, row in enumerate(country_totals_flow.itertuples(index=False))
}
province_index = {
    p: len(country_nodes) + i
    for i, p in enumerate(province_totals_flow["province"])
}
sources = [country_index[(int(r.country_code), r.country)] for r in flow_data.itertuples(index=False)]
targets = [province_index[r.province] for r in flow_data.itertuples(index=False)]
link_codes = flow_data["country_code"].astype(int).tolist()

default_links = ["rgba(1, 105, 111, 0.28)"] * len(flow_data)
default_nodes = (["rgba(231, 111, 81, 0.88)"] * len(country_nodes)
                 + ["rgba(1, 105, 111, 0.78)"] * len(province_nodes))
hover = [
    f"<b>{flag(ISO2_BY_NUMERIC.get(int(r.country_code)))} {COUNTRY_EN.get(r.country, r.country)} → 🇮🇹 {PROVINCE_EN.get(r.province, r.province)}</b><br>"
    f"Presenze: {r.nights:,.0f}<br>Arrivi: {r.arrivals:,.0f}<br>"
    f"Soggiorno medio: {r.nights / r.arrivals:.2f} notti"
    if r.arrivals else f"<b>{COUNTRY_EN.get(r.country, r.country)} → {PROVINCE_EN.get(r.province, r.province)}</b><br>Presenze: {r.nights:,.0f}"
    for r in flow_data.itertuples(index=False)
]

sankey_fig = go.Figure(go.Sankey(
    arrangement="snap",
    node=dict(
        pad=24, thickness=18, x=node_x, y=node_y,
        line=dict(color="#ffffff", width=0.8), label=labels, color=default_nodes,
        hovertemplate="%{label}<br>%{value:,.0f} presenze<extra></extra>",
    ),
    link=dict(
        source=sources, target=targets, value=flow_data["nights"], color=default_links,
        customdata=hover, hovertemplate="%{customdata}<extra></extra>",
    ),
))

sankey_buttons = [dict(
    label="Tutti i Paesi", method="restyle",
    args=[{"link.color": [default_links], "node.color": [default_nodes], "node.label": [labels]}],
)]
for row in country_totals_flow.itertuples(index=False):
    selected = int(row.country_code)
    selected_provinces = set(flow_data.loc[flow_data["country_code"].eq(selected), "province"])
    selected_links = [
        "rgba(231, 111, 81, 0.90)" if code == selected else "rgba(108, 117, 125, 0.035)"
        for code in link_codes
    ]
    selected_nodes = [
        "rgba(231, 111, 81, 0.95)" if int(code) == selected else "rgba(108, 117, 125, 0)"
        for code in country_totals_flow["country_code"]
    ] + [
        "rgba(1, 105, 111, 0.95)" if province in selected_provinces else "rgba(108, 117, 125, 0)"
        for province in province_totals_flow["province"]
    ]
    selected_labels = [
        label if int(code) == selected else ""
        for label, code in zip(country_nodes, country_totals_flow["country_code"])
    ] + [
        label if province in selected_provinces else ""
        for label, province in zip(province_nodes, province_totals_flow["province"])
    ]
    sankey_buttons.append(dict(
        label=f"{flag(ISO2_BY_NUMERIC.get(selected))} {COUNTRY_EN.get(row.country, row.country)}", method="restyle",
        args=[{"link.color": [selected_links], "node.color": [selected_nodes], "node.label": [selected_labels]}],
    ))

sankey_fig.update_layout(
    title=dict(text=f"Dalle residenze estere alle province italiane: flussi turistici {SANKey_YEAR}", x=0.02, xanchor="left"),
    font=dict(family="Arial, sans-serif", size=13, color=TEXT),
    paper_bgcolor=BG, plot_bgcolor=BG, margin=dict(l=20, r=20, t=145, b=20), height=900,
    updatemenus=[dict(
        buttons=sankey_buttons, direction="down", x=0.02, y=1.16, xanchor="left", yanchor="top",
        bgcolor=PANEL, bordercolor=GRID, borderwidth=1, font=dict(size=13),
    )],
    annotations=[dict(
        text="Seleziona un Paese per evidenziare i flussi verso le destinazioni.", x=0.02, y=1.08,
        xref="paper", yref="paper", showarrow=False, xanchor="left", font=dict(size=12, color=MUTED),
    )],
)
sankey_fig
```
Il diagramma di Sankey è filtrato intenzionalmente sui principali mercati, sulle destinazioni e sui collegamenti sopra una dimensione minima. In questo modo la visualizzazione rimane leggibile e conserva la stessa logica Paese-provincia dell'analisi originale. Seleziona un Paese dal menu a tendina per isolare la sua rete.
## Seguire i flussi nel corso degli anni
La seconda vista anima la stessa idea nel tempo. Per mantenere l'articolo autonomo e riproducibile, usa una piccola tabella locale di coordinate per i principali mercati esteri e capoluoghi di provincia, invece di scaricare file geografici durante il rendering. Il risultato conserva l'interazione utile della mappa originale: premi Play o sposta il cursore degli anni per vedere come cambiano destinazioni e origini internazionali dal 2019 al 2025.
```{python}
#| code-fold: true
#| code-summary: "Mostra il codice della mappa animata"
from IPython.display import HTML, display

TOP_COUNTRIES_MAP = 10
TOP_DESTINATIONS_PER_COUNTRY = 3

country_coordinates = {
    "Germania": (51.16, 10.45), "Stati Uniti d'America": (39.83, -98.58),
    "Francia": (46.23, 2.21), "Regno Unito": (55.38, -3.44),
    "Svizzera e Liechtenstein": (46.82, 8.23), "Paesi Bassi": (52.13, 5.29),
    "Polonia": (51.92, 19.15), "Austria": (47.52, 14.55),
    "Spagna": (40.46, -3.75), "Belgio": (50.50, 4.47),
    "Canada": (56.13, -106.35), "Australia": (-25.27, 133.78),
    "Brasile": (-14.24, -51.93), "Israele": (31.05, 34.85),
}

def marker_size(values, low, high):
    values = np.asarray(values, dtype=float)
    if values.max() == values.min():
        return np.repeat((low + high) / 2, len(values))
    roots = np.sqrt(values)
    return low + (roots - roots.min()) / (roots.max() - roots.min()) * (high - low)


province_map_coordinates = {
    p: coordinates for p, coordinates in province_coordinates.items()
}

def map_frame_data(year):
    yearly = provincial.query("year == @year and country_code.between(1, 887)").copy()
    top_countries = (
        yearly.groupby("country", as_index=False)["nights"]
        .sum().nlargest(TOP_COUNTRIES_MAP, "nights")
    )
    flows = yearly.merge(top_countries[["country"]], on="country")
    flows["rank"] = flows.groupby("country")["nights"].rank(method="first", ascending=False)
    flows = flows[flows["rank"] <= TOP_DESTINATIONS_PER_COUNTRY].copy()
    flows["province"] = flows["province"].astype(str).str.strip().str.title()
    flows["country_lat"] = flows["country"].map(lambda value: country_coordinates.get(value, (np.nan, np.nan))[0])
    flows["country_lon"] = flows["country"].map(lambda value: country_coordinates.get(value, (np.nan, np.nan))[1])
    flows["province_lat"] = flows["province"].map(lambda value: province_map_coordinates.get(value, (np.nan, np.nan))[0])
    flows["province_lon"] = flows["province"].map(lambda value: province_map_coordinates.get(value, (np.nan, np.nan))[1])
    flows = flows.dropna(subset=["country_lon", "country_lat", "province_lon", "province_lat"])
    destinations = flows.groupby(["province", "province_lon", "province_lat"], as_index=False).agg(
        arrivals=("arrivals", "sum"), nights=("nights", "sum")
    )
    destinations["average_stay"] = destinations["nights"] / destinations["arrivals"].replace(0, np.nan)
    origins = flows.groupby(["country", "country_lon", "country_lat"], as_index=False).agg(nights=("nights", "sum"))
    return flows, destinations, origins


map_years = sorted(provincial["year"].unique())
map_country_order = sorted({
    country
    for year in map_years
    for country in (
        provincial.query("year == @year and country_code.between(1, 887)")
        .groupby("country")["nights"]
        .sum()
        .nlargest(TOP_COUNTRIES_MAP)
        .index
    )
})


def map_traces(flows, destinations, origins):
    traces = []
    for country_index, country in enumerate(map_country_order):
        country_flows = flows[flows["country"].eq(country)].copy()
        if country_flows.empty:
            traces.extend([
                go.Scattergeo(lon=[], lat=[], mode="lines", showlegend=False),
                go.Scattergeo(lon=[], lat=[], mode="markers", showlegend=False),
                go.Scattergeo(lon=[], lat=[], mode="markers", showlegend=False),
            ])
            continue

        line_lon, line_lat = [], []
        for row in country_flows.itertuples():
            line_lon += [row.country_lon, row.province_lon, None]
            line_lat += [row.country_lat, row.province_lat, None]
        traces.append(go.Scattergeo(
            lon=line_lon, lat=line_lat, mode="lines", hoverinfo="skip", showlegend=False,
            line=dict(color="rgba(1, 105, 111, 0.27)", width=1.2),
        ))

        country_destinations = country_flows.groupby(
            ["province", "province_lon", "province_lat"], as_index=False
        ).agg(arrivals=("arrivals", "sum"), nights=("nights", "sum"))
        country_destinations["average_stay"] = (
            country_destinations["nights"] / country_destinations["arrivals"].replace(0, np.nan)
        )
        country_destinations["province_display"] = country_destinations["province"].map(PROVINCE_EN).fillna(country_destinations["province"])
        traces.append(go.Scattergeo(
            lon=country_destinations.province_lon, lat=country_destinations.province_lat, mode="markers",
            marker=dict(size=marker_size(country_destinations.nights, 8, 34), color=TEAL, opacity=0.82,
                        line=dict(color="white", width=0.8)),
            customdata=np.c_[country_destinations.province_display, country_destinations.arrivals,
                             country_destinations.nights, country_destinations.average_stay],
            hovertemplate=("<b>%{customdata[0]}</b><br>Arrivi: %{customdata[1]:,.0f}"
                           "<br>Presenze: %{customdata[2]:,.0f}<br>Soggiorno medio: %{customdata[3]:.2f} notti<extra></extra>"),
            name="Province di destinazione", showlegend=country_index == 0,
        ))

        country_origin = country_flows.iloc[0]
        country_nights = country_flows["nights"].sum()
        country_display = COUNTRY_EN.get(country, country)
        traces.append(go.Scattergeo(
            lon=[country_origin.country_lon], lat=[country_origin.country_lat], mode="markers+text",
            text=[country_display], textposition="top center", textfont=dict(size=10, color=TEXT),
            marker=dict(size=marker_size([country_nights], 7, 20)[0], color=CORAL, opacity=0.9,
                        line=dict(color="white", width=0.8)),
            customdata=[[country_display, country_nights]],
            hovertemplate="<b>%{customdata[0]}</b><br>Presenze nelle tre destinazioni principali: %{customdata[1]:,.0f}<extra></extra>",
            name="Residenze estere", showlegend=country_index == 0,
        ))
    return traces


map_frames = []
for year in map_years:
    map_flows, map_destinations, map_origins = map_frame_data(year)
    map_frames.append(go.Frame(name=str(year), data=map_traces(map_flows, map_destinations, map_origins)))

first_flows, first_destinations, first_origins = map_frame_data(map_years[0])
flow_map_fig = go.Figure(
    data=map_traces(first_flows, first_destinations, first_origins),
    frames=map_frames,
)
flow_map_fig.update_layout(
    title=dict(text="Flussi turistici internazionali verso le province italiane", x=0.02, xanchor="left"),
    margin=dict(l=15, r=15, t=105, b=90), height=1000, paper_bgcolor=BG,
    font=dict(color=TEXT), legend=dict(orientation="h", y=0.16, x=0.02),
    geo=dict(
        scope="world", domain=dict(x=[0, 1], y=[0.12, 0.91]),
        projection=dict(type="natural earth", scale=1.6),
        center=dict(lon=-35, lat=47), showland=True, landcolor=PANEL,
        showcountries=True, countrycolor=GRID, showocean=True, oceancolor="#e8f1f2",
        lonaxis=dict(range=[-110, 35]), lataxis=dict(range=[0, 80]), bgcolor=BG,
    ),
    updatemenus=[dict(
        type="buttons", direction="left", x=0.02, y=-0.1, xanchor="left", yanchor="middle",
        showactive=False, pad=dict(t=4, r=8, b=4, l=8),
        buttons=[
        dict(label="▶ Play", method="animate", args=[None, {"frame": {"duration": 900, "redraw": True}, "fromcurrent": True}]),
        dict(label="❚❚ Pause", method="animate", args=[[None], {"frame": {"duration": 0, "redraw": False}, "mode": "immediate"}]),
    ]), dict(
        type="buttons", direction="left", x=0.98, y=1.02, xanchor="right", yanchor="top",
        showactive=False, pad=dict(t=4, r=8, b=4, l=8),
        buttons=[dict(
            label="↺ Tutti i Paesi", method="restyle",
            args=[{"visible": [True] * (len(map_country_order) * 3)}],
        )],
    )],
    sliders=[dict(
        active=0, x=0.22, y=0.045, len=0.62, pad=dict(t=8, b=0),
        currentvalue={"prefix": "Anno: ", "font": {"size": 18}},
        steps=[dict(label=str(year), method="animate", args=[[str(year)], {"mode": "immediate", "frame": {"duration": 0, "redraw": True}}]) for year in map_years],
    )],
    annotations=[dict(
        text=f"Clicca su un mercato estero per mostrare le sue {TOP_DESTINATIONS_PER_COUNTRY} destinazioni principali; usa Tutti i Paesi per ripristinare la vista.",
        x=0.02, y=0.96, xref="paper", yref="paper", showarrow=False,
        font=dict(size=12, color=MUTED), align="left",
    )],
)
flow_map_fig.update_layout(height=1000)

map_click_script = """
const plot = document.getElementById('{plot_id}');
const groupCount = %d;
const totalTraces = groupCount * 3;
plot.on('plotly_click', (event) => {
  const point = event.points[0];
  if (point.curveNumber %% 3 !== 2) return;
  const selectedGroup = Math.floor(point.curveNumber / 3);
  const visible = Array(totalTraces).fill(false);
  visible[selectedGroup * 3] = true;
  visible[selectedGroup * 3 + 1] = true;
  visible[selectedGroup * 3 + 2] = true;
  Plotly.restyle(plot, {visible});
});
""" % len(map_country_order)

display(HTML(flow_map_fig.to_html(
    full_html=False, include_plotlyjs=False, div_id="tourism-flow-map", post_script=map_click_script
)))
```
La mappa animata mette in evidenza un aspetto dei dati diverso da quello del diagramma di Sankey. Il Sankey è più adatto a confrontare la struttura della rete nel 2025; la mappa mostra meglio come i principali mercati internazionali e le destinazioni si muovano durante la ripresa.
# Che cosa portarsi a casa
I tre file descrivono lo stesso sistema turistico a diverse risoluzioni:
- **Tempo:** la ricettività italiana è cresciuta enormemente nel lungo periodo, ha subito un'interruzione storica nel 2020 e ha raggiunto un nuovo massimo provvisorio nel 2025.
- **Luogo:** la domanda è concentrata geograficamente in un gruppo relativamente ristretto di destinazioni urbane, culturali, montane e costiere.
- **Residenza:** il turismo internazionale è centrale nella ripresa; la Germania è il principale mercato estero nel 2025.
- **Calendario:** agosto rimane il mese di punta, quindi la crescita annuale non si distribuisce uniformemente nel corso dell'anno.
Ci sono anche due lezioni metodologiche. Primo, arrivi e presenze rispondono a domande diverse: gli arrivi misurano il volume dei viaggi, mentre le presenze ne catturano la durata. Secondo, il 2025 va trattato con cautela. La fonte lo indica come provvisorio e segnala un cambiamento nella copertura; un'analisi corretta dovrebbe quindi evidenziarlo, invece di presentarlo come perfettamente comparabile con ogni anno precedente.
La naturale estensione successiva sarebbe combinare queste tabelle sulle presenze con l'offerta ricettiva — posti letto, strutture e tassi di occupazione — oppure costruire una tipologia delle destinazioni che distingua il turismo urbano da quello balneare, montano e lacustre.
## Riprodurre l'analisi
I file sorgente usati qui sono le tavole ufficiali ISTAT sul turismo incluse nell'articolo. Per definizioni e futuri aggiornamenti, consulta il [portale ISTAT delle statistiche sul turismo](https://www.istat.it/it/statistiche-per-temi/servizi/turismo/).
Vuoi eseguire nuovamente l'analisi? Scarica il notebook completo e i tre file sorgente.
[Scarica il notebook](/downloads/italian_tourism_occupancy_analysis.ipynb){.btn .btn-primary data-cta-id="italian-tourism-notebook-download" download="italian_tourism_occupancy_analysis.ipynb"}
Il notebook si aspetta di trovare questi file nella stessa cartella:
[Serie storica](/downloads/1_serie_storica.xlsx){.btn .btn-outline-secondary download="1_serie_storica.xlsx"}
[Dati provinciali per residenza](/downloads/3_dati_provinciali_per_provenienza.xlsx){.btn .btn-outline-secondary download="3_dati_provinciali_per_provenienza.xlsx"}
[Dati comunali](/downloads/2_dati_comunali.xlsx){.btn .btn-outline-secondary download="2_dati_comunali.xlsx"}
I file originali provengono dalla cartella di analisi `DCSC_Occupancy_in_collective_accommodation`. Il codice dell'articolo legge intenzionalmente i file con `header=None`, assegna nomi espliciti ai campi e filtra le righe aggregate prima di calcolare le classifiche. In questo modo le decisioni di pulizia rimangono visibili e facili da adattare.
*Questo articolo è descrittivo. Non stima effetti causali, non prevede l'andamento del turismo e non tratta i valori provvisori del 2025 come definitivi.*